- Published on
从文档到知识图谱:用 Ontology 引导文档预处理
- Authors

- Name
- 浩森 Hansen
AI 应该如何“阅读”一篇文章?
阅读是人类获取信息的一种方式。我们阅读一篇文章或一本书,在脑海里整理信息,形成自己的观点。
让 AI 帮忙阅读,最常见的方式就是把一整篇文章交给它,让它做总结、提炼、归纳,甚至生成图谱。但这里有一个问题:AI 的阅读和人类的阅读不一样。
我试过让 AI 根据一篇文章生成图谱,结果往往不尽人意,还需要人工核对、修正和补充。
我时常发现,AI 阅读的问题主要集中在:
- 文章很长,AI 一次吃不下
- AI 的阅读不受约束,容易跑题、胡编乱造
- AI 的阅读不受关注点约束,容易漏掉用户关心的内容
这些问题让我开始思考:在接入知识图谱之前,能否先建立一个受关注点约束、处理结果可核对的文档预处理过程?
要把一篇文档作为一个模块接入用户已有的 Ontology 知识图谱,首先需要从文档中整理出符合其关注点的信息。这篇文章讨论的,就是接入之前的预处理过程:输入文本与 ontology,输出一张包含关键词、定义及相关证据的词表,为后续接入做准备。
对此,我有两个方面的想法:
第一,用输入的 ontology 明确 AI 的关注点,让它知道要从文档中提取什么信息。
第二,把 AI 的阅读过程拆分为两个阶段:粗读和细读。和人一样,先粗读一遍,了解文章大概在讲什么,然后再细读,按关注点去提取信息。
Ontology(本体论)是什么
在人工智能领域,ontology 是对某个领域的知识进行建模的方式。它可以用来描述一个领域中的概念、属性和关系。
在我们的场景里,用大白话说,ontology 就是一份「用户关心什么」的描述清单。
它可以约定:要关注哪些类型(比如术语、人物、事件)、每种类型大概长什么样、输出时结果表该有哪些栏。它就像一份阅读提纲,约定我们带着哪些关注点阅读,也指导后续的信息抽取。
同一篇文档,换一份 ontology,关心的关键词类型可以完全不一样。所以抽取不能「模型随便总结一通」,而要按当前这份 ontology 来问、来填、来检查。
在这个预处理模块中,ontology 提供处理要求,文本提供待处理的内容。接下来,我们依次通过候选发现、粗读、细读与整理,将文本中的信息汇集成符合关注点的关键词表。
候选发现:准备一张候选词表
正式阅读之前,我们先找出候选词。就像阅读时先圈出值得留意的词语,再在后续阅读中逐步补充批注,这一步先找出文档中可能值得关注的内容,并记录它们的位置。
这一步一般不用语言模型,而是先用低成本的算法清理文档、识别候选词。它解决一个问题:文档的关键点有哪些?分别在哪些位置?
这些内容会汇集到一张候选词表中。它是贯穿整个处理过程的数据结构:候选发现阶段先建立词表,细读时不断补充证据和建议,最后经过整理与归一化,这张表就成为最终的关键词表。
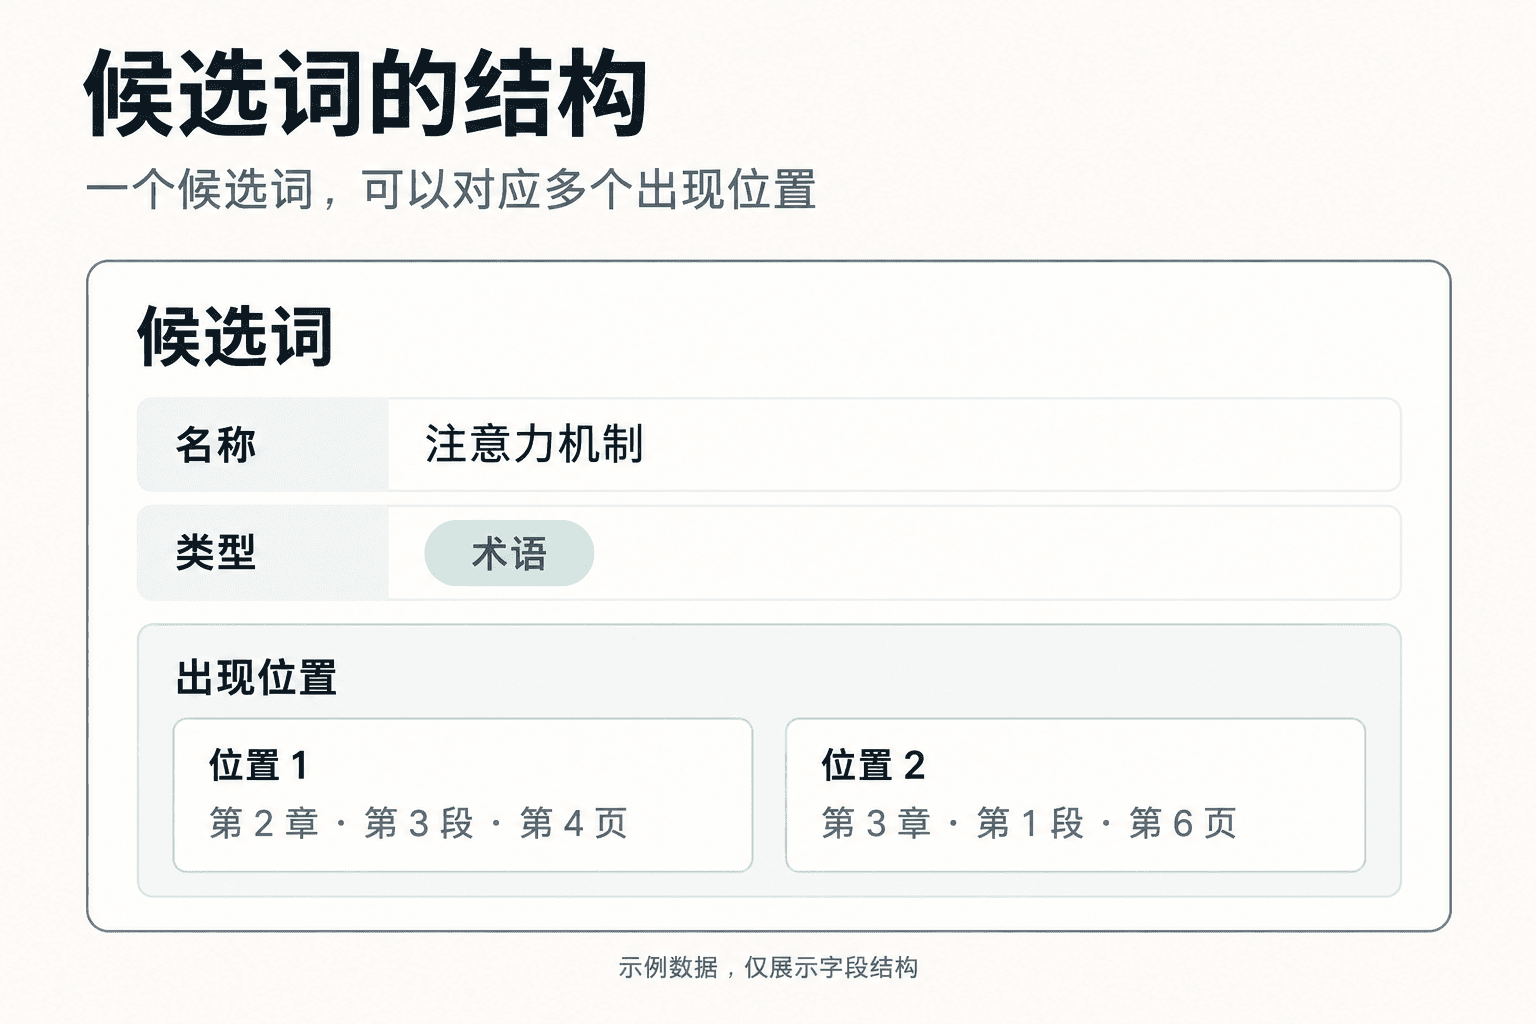
候选词表里面应该包含:
- 文档中出现的所有可能的关键词(术语、人物、事件等)
- 关键词出现的位置(章节、段落、页码等)
这张表不需要一次填完,后续模型会对照 ontology 这份阅读提纲,逐步补充、核对和筛选其中的内容。候选词表的质量直接影响后续抽取的效率和准确性。
粗读:画出文章的地图
粗读关注文章和章节的结构与主题,帮助我们了解全文梗概。它就像画出一张文章的地图,让后续细读每个片段时,都知道这段内容处于什么位置、与全文有什么联系。粗读之后,我们应该拿到:
- 一个文章梗概(文章 Meta)
- 每个章节的梗概(章节 Meta)
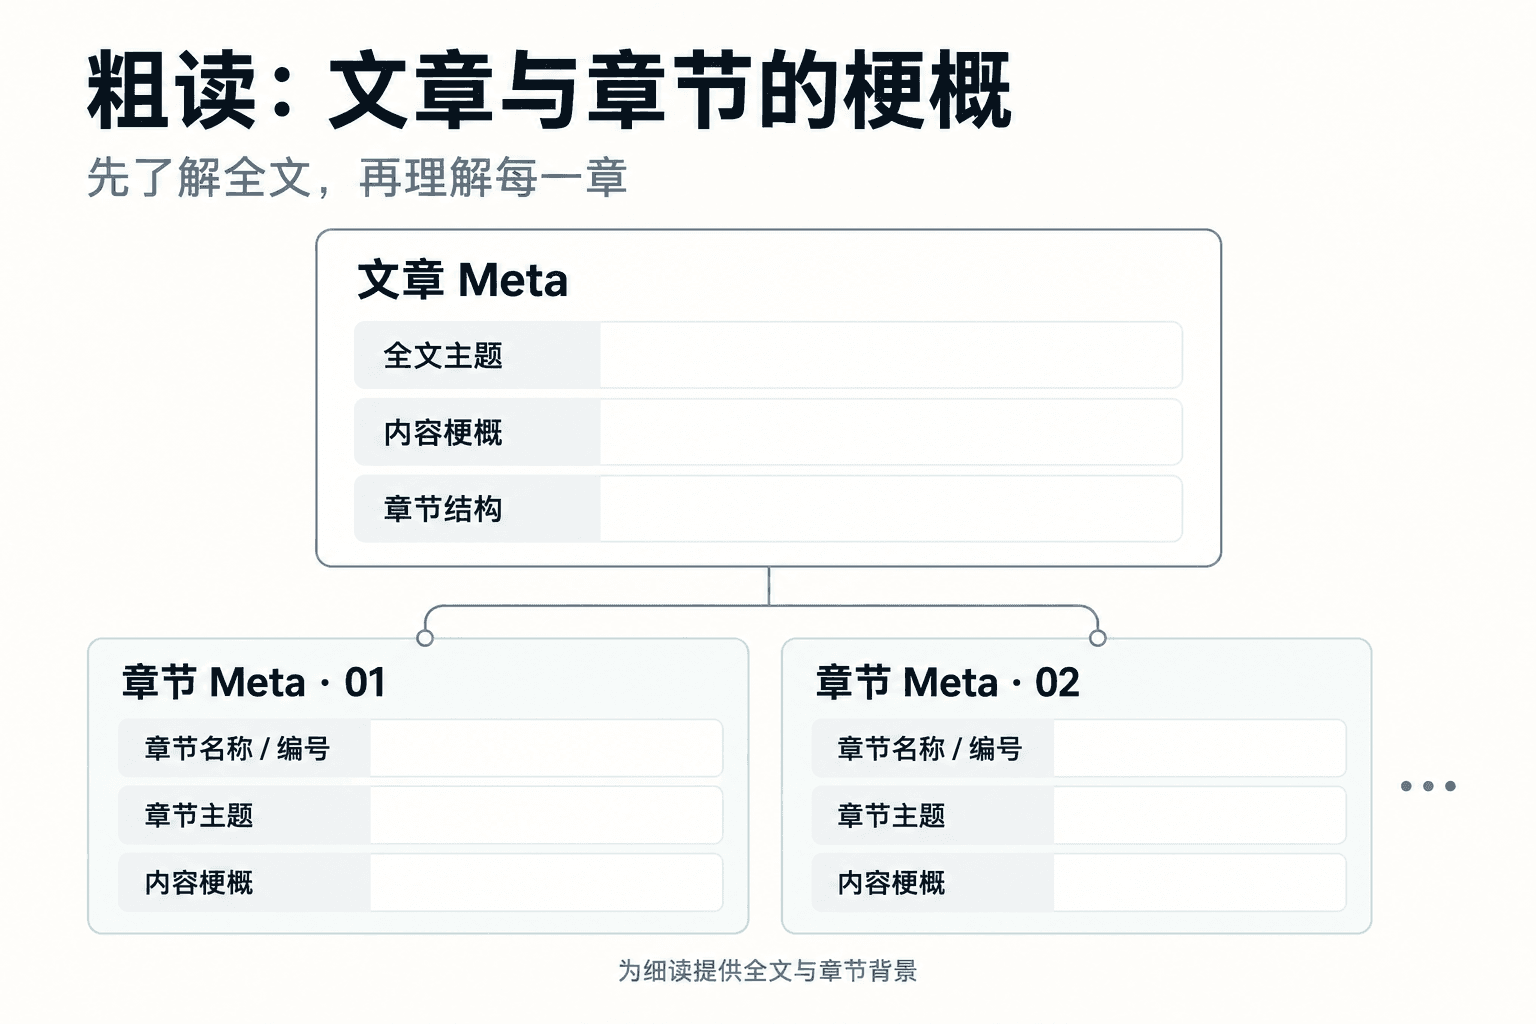
为了节省预算,粗读可以抽样进行。一般来说,文章的开头和结尾格外重要,所以我们可以取全文以及每一章的开头和结尾段落,作为粗读的样本。这足以形成文章梗概了。
细读:带着关注点做批注
现在我们手上有四个东西:
- 文档正文
- 一份阅读提纲:当前的 ontology(关注类型与填表规矩)
- 一张待完善的候选词表(包含文档中出现的所有可能的关键词,以及关键词出现的位置)
- 一张地图:文档 Meta 和章节 Meta(粗读的结果)
有了这些东西,细读就有了明确的方向。
细读往往需要对正文分片,这里暂不讨论如何分片,假设我们已经把文章分成了若干个片段。每个片段都可以单独处理,按关注点去提取信息。
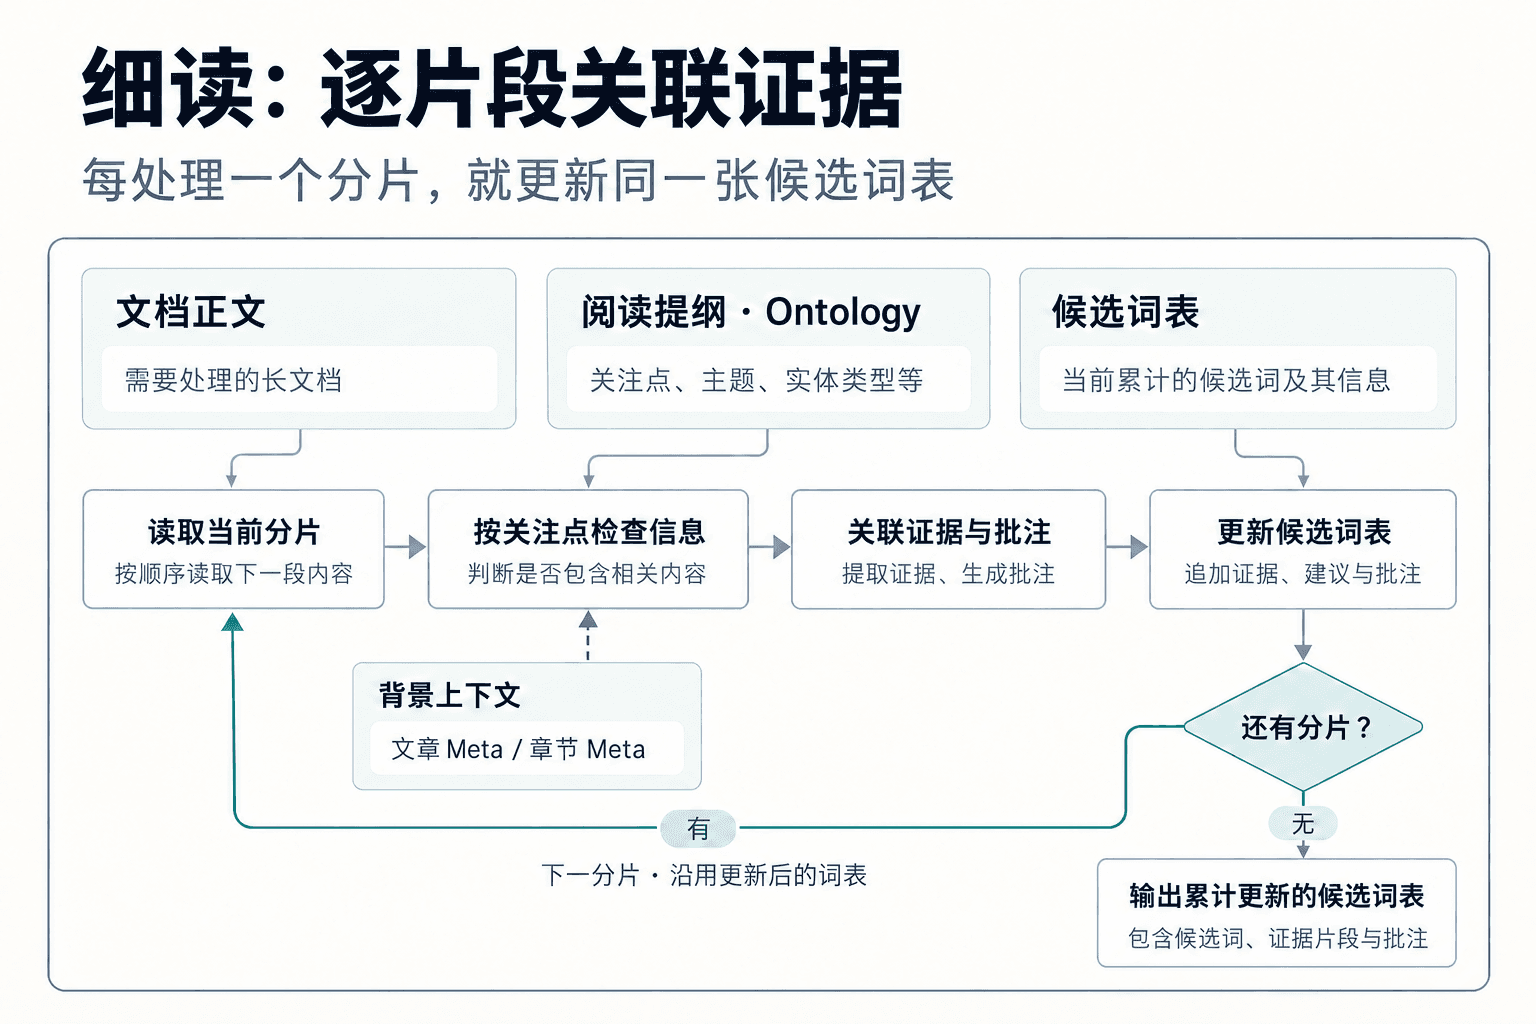
细读的过程是一个循环:每次处理一个分片。模型对照 ontology 这份阅读提纲检查信息,并把建议附在候选词表上。就像我们读到相关段落时,在圈出的词语旁写下批注,这一步把候选词与对应的原文联系起来,也就是证据关联过程。
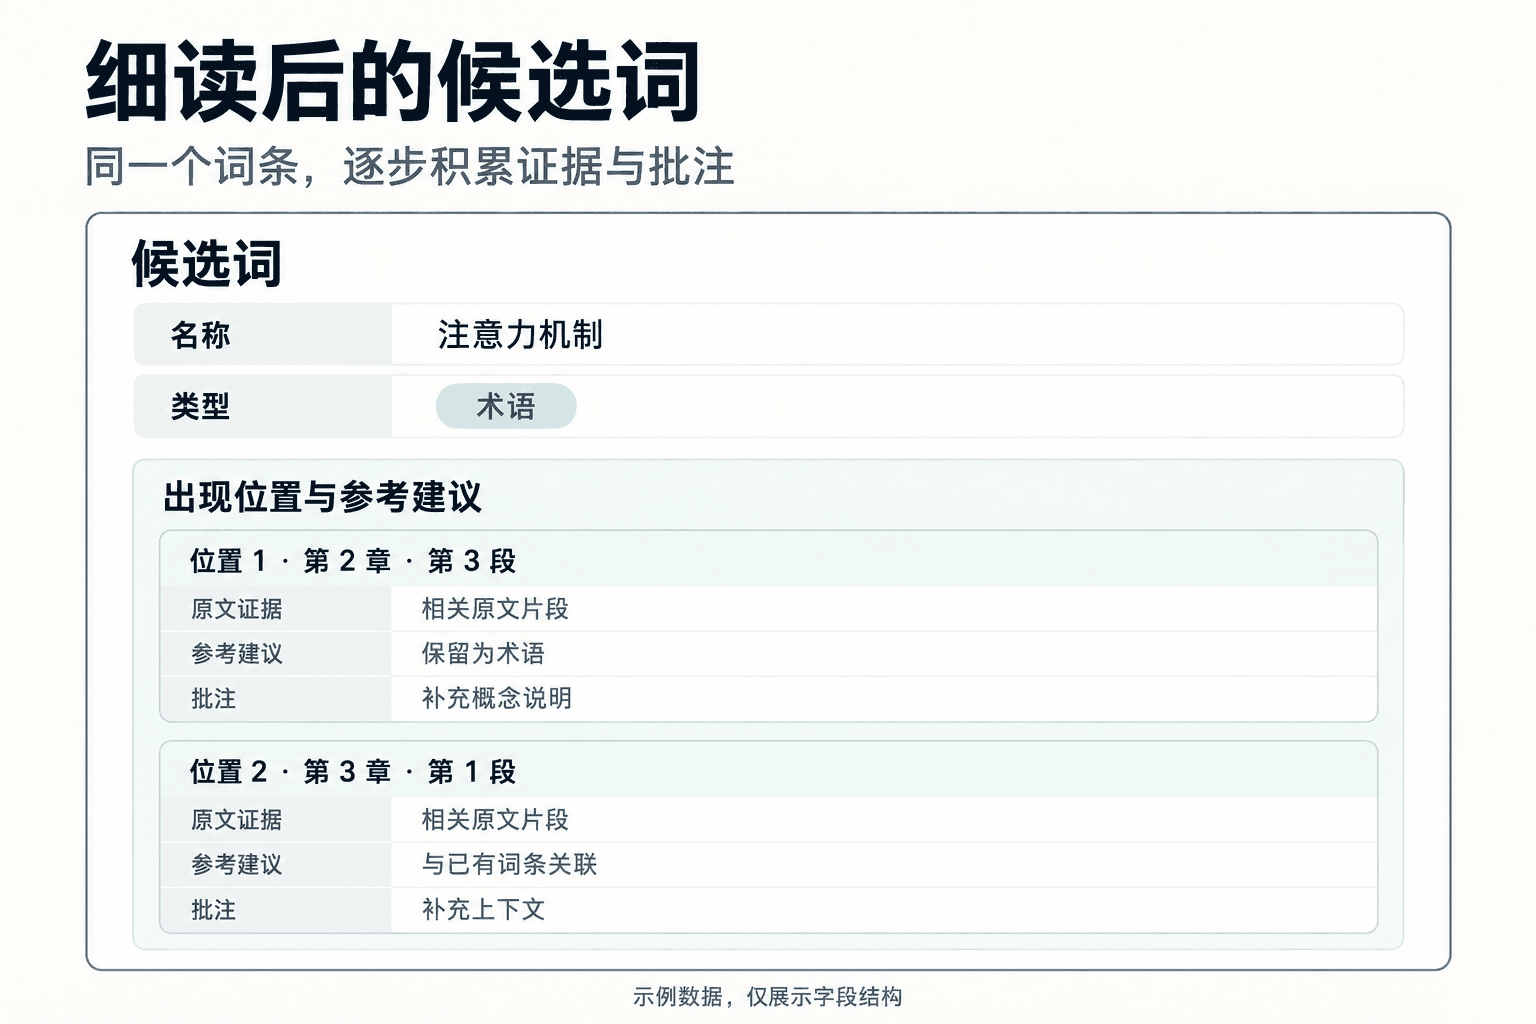
完成之后,候选词表应该长这样:
- 关键词1:(出现位置1,参考建议1)、(出现位置2,参考建议2)、(出现位置3,参考建议3)
- 关键词2:(出现位置1,参考建议1)、(出现位置2,参考建议2)
整理:把阅读笔记归入词表
读完文章,还需要整理阅读笔记。模型汇总候选词表中积累的证据和建议,把重复、相似的关键词进行合并,并对每个关键词进行定义。这个过程就是归一化,让阅读过程中陆续记录的内容形成统一的结果。
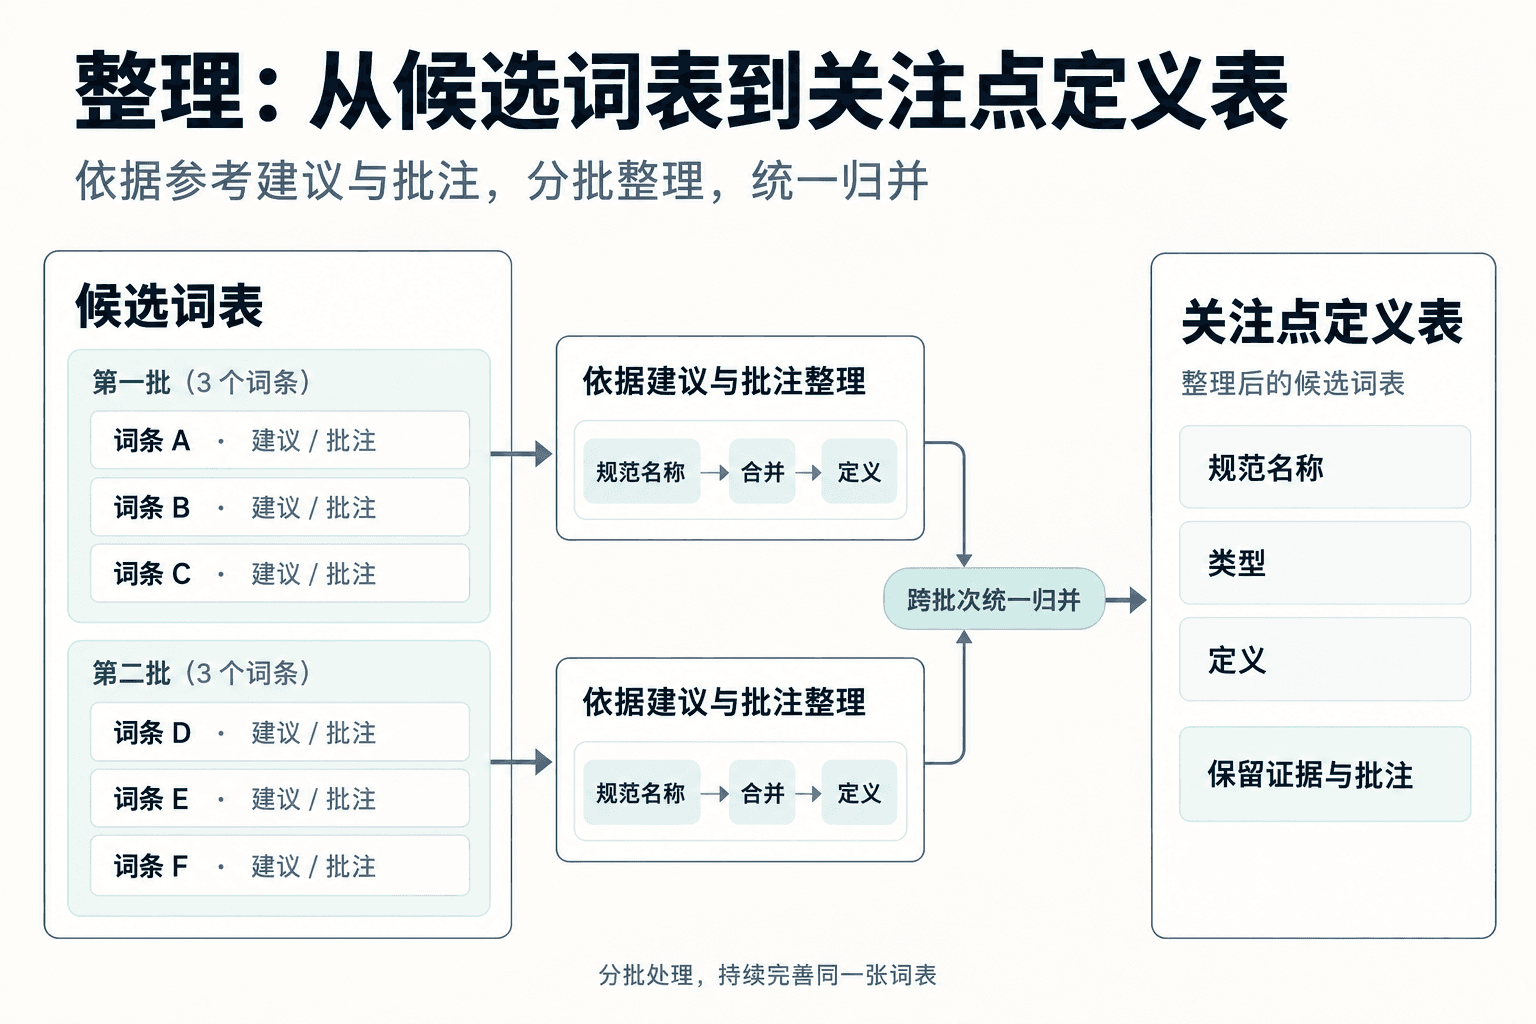
至此,这张不断完善的候选词表就成为我们想要的最终关键词表:对准用户的关注点,并且每个关键词都有定义。
示例:用《Attention Is All You Need》提取关键术语
以论文 《Attention Is All You Need》 为例,我们把论文文本和术语类 ontology 作为输入,关注模型架构、注意力机制及相关组件,输出带有定义和原文关联的候选词表。
下面用 Miremo 的一组真实测试结果,展示三个候选词从预选到整理的变化。这些结果仍待评审,尚未正式采纳到知识图谱。
本次测试的执行流程与算法
本例使用 JATE 3.3.0 的 C-Value 做术语预选,spaCy 3.8 + en_core_web_sm 做英文语言处理,qwen3.7-flash 做语义阅读和整理。以下是这组历史测试的实际处理链。
执行流程: 组织章节与分片 → 分词和词性标注 → 生成候选并评分 → 规范化与原文定位 → 粗读 → 逐片段细读 → 候选整理、归并与定义复核。
数据流: 论文文本 → 章节表、分片表;全文经过术语预选得到候选词表;文本与 ontology 生成文章/章节 Meta;候选词表、Meta、ontology 与正文分片共同进入细读;积累的证据和批注经整理,形成最终关注点定义表。
| 步骤 | 本次使用的方法与参数 | 输出数据 |
|---|---|---|
| 文本组织与分片 | 采用结构优先的切分规则,依据标题、段落、图注及公式边界组织文本;分片上限为 1200 字符,图示相关内容单独分片。 | 11 个章节、59 个分片;保留原文顺序和位置。 |
| 英文分词 | spaCy 的英文 tokenizer,将文本切为 token,保留字符偏移。 | token 序列及原文位置。 |
| 词性标注 | en_core_web_sm 标注词性,候选生成使用 ADJ(形容词)、NOUN(名词)、PROPN(专有名词)等标签。 | 带词性标签的 token 序列。 |
| 候选短语生成 | JATE 默认 POS 模式:由形容词、名词或专有名词组成,并以名词或专有名词结尾;长度 1–5 词,最低频次为 1。 | 待评分的单词与多词短语。 |
| 术语评分 | 使用 C-Value,结合词数、出现频次及被更长候选包含的情况评分。按整篇论文统计,不把分片当作独立语料文档。 | 1020 条带评分和排序的候选。 |
| 名称规范化与去重 | 去掉名称前的 Markdown 井号,统一连字符空格;借助 spaCy 对复数名词进行词形归一,按匹配键去重;排除无字母的纯符号项,不做 Top-K 截断。 | 994 条初始候选,保留算法分数和来源。 |
| 原文定位与建表 | 使用边界匹配、大小写/空白规范化和英文名词词形匹配,将候选关联回分片;记录起止偏移,并建立分片到候选的反向索引。 | mentions、mention_shard_ids、occurrences 等字段;定义与分类暂留空。 |
| 粗读 | 使用 qwen3.7-flash,关闭思考模式;根据抽样正文和 ontology 生成全文背景、章节背景与关注点。本轮复用经输入一致性检查的既有粗读结果。 | 文章 Meta、章节 Meta。 |
| 细读 | 同一模型逐片段读取正文,结合 Meta 和 ontology 检查候选,追加关联理解、名称建议及新发现。 | 带原文关联和参考批注的候选词表。 |
| 整理与复核 | 同一模型完成候选判断、身份比较与归并、定义生成、去噪及独立复核,结合追加审阅修订保留处理记录。 | 本轮交付的 160 条候选及其定义、证据、归并映射和评审状态。 |
C-Value 的作用是给候选排序:如果一个短词主要作为更长短语的一部分出现,它的评分会扣除相应的嵌套频次影响。本次实现的长度权重为:
其中 是候选词组 的词数,因此单词也可以获得分数。分数不是术语有效性的概率;本例保留完整候选池,把语义筛选交给后续阅读与整理。
预选表采用结构化 JSON 保存,并与章节表、分片表关联。这里的 994 条是初始词形候选,160 条是后续归并、筛选后的交付记录,两者不能直接换算为抽取准确率。
预选:候选表里最初有什么?
这一轮使用 JATE 算法建立了 994 条预选候选。先看其中三条,保留它们最初的名称:
| 字段 | attention | transformer | feed |
|---|---|---|---|
| 候选编号(id) | J0016 | J0055 | J0630 |
| 预选名称(name) | attention | transformer | feed |
| 来源(origins) | 文档 · keyword_algorithm | 文档 · keyword_algorithm | 文档 · keyword_algorithm |
| 算法评分(algorithm_scores) | JATE C-Value:4.5139 | JATE C-Value:3.1626 | JATE C-Value:0.3438 |
| 排序(rank) | 16 | 55 | 630 |
| 匹配次数(occurrences) | 101 | 28 | 7 |
| 出现分片(mention_shard_ids) | SH002、SH003、SH004、SH006、SH007、SH008、SH010、SH011、SH012、SH013、SH014、SH015、SH017、SH018、SH020、SH021、SH022、SH023、SH024、SH025、SH026、SH027、SH030、SH031、SH032、SH033、SH044、SH045、SH048、SH052、SH053、SH057、SH058、SH059 | SH003、SH004、SH006、SH007、SH008、SH010、SH011、SH024、SH038、SH041、SH043、SH045、SH046、SH047、SH048 | SH010、SH012、SH020、SH026、SH033 |
| 具体位置(mentions) | SH002:3–12;SH003:233–242(节选) | SH003:304–315;SH003:1007–1018(节选) | SH010:104–108;SH010:163–167(节选) |
| 匹配方式/语言 | normalized / en | normalized / en | normalized / en |
| 定义/依据位置(definition / definition_shard_ids) | 空,待细读后补充 | 空,待细读后补充 | 空,待细读后补充 |
| 分类/分类依据(classification / classification_shard_ids) | 未分类;依据为空 | 未分类;依据为空 | 未分类;依据为空 |
| 参考分类/语义说明(reference_classifications / sense) | 空 | 空 | 空 |
| 处理状态(status) | preselected | preselected | preselected |
| 修订/历史/冲突(revision / history / conflicts) | 0 / 空 / 空 | 0 / 空 / 空 | 0 / 空 / 空 |
名称用于识别候选词,出现位置用于回查原文,评分和次数提供预选参考,定义与分类留待细读补充。SH 表示正文分片;具体位置是片内字符范围。表中展示主要业务字段,长位置列表保留,单次匹配只取两处示例。
粗读:文章 Meta
下面是本轮测试的文章 Meta 节选,省略内部编号:
| 字段 | 用途 | 真实输出(节选) |
|---|---|---|
| 全文概述(overview) | 提供全文背景。 | 本文介绍了Transformer架构,一种完全基于注意力机制的新颖网络结构,摒弃了传统的循环和卷积。该模型在机器翻译任务上取得了优于现有最佳结果的BLEU分数,且训练成本显著降低,并展示了在其他任务(如句法分析)上的良好泛化能力。 |
| 内容角色(content_role) | 说明各部分的作用。 | 标题、作者信息及摘要,确立了文档的核心贡献(Transformer架构)和实验结果;参考文献列表;注意力可视化示例,用于解释模型内部机制。 |
| 抽取关注点(focus) | 明确要提取的信息。 | 关注核心模型架构及其关键组件。重点识别‘Transformer’作为整体架构,‘attention mechanism’作为核心机制,以及其具体变体如‘scaled dot product attention’、‘multi-head attention’和‘self-attention’。 |
| 补充字段 | 用途 | 真实记录 |
|---|---|---|
| 依据位置(overview.shard_ids) | 定位梗概依据。 | SH002、SH003、SH004 |
| 待确认/补充说明(ontology_specific.uncertainties) | 保留模型的范围判断与待核对说明。 | 候选提示中包含大量人名、会议名称及参考文献条目,这些不属于具有专业定义的术语,已根据指南排除。部分通用词汇如'model'、'task'因缺乏特定专业定义语境而未抽取。 |
章节 Meta
章节 Meta 用于补充局部背景。下面保留两个章节的真实输出节选:
Model Architecture
| 字段 | 用途 | 真实输出(节选) |
|---|---|---|
| 章节概述(overview) | 说明本章讲什么。 | 本章详细阐述了Transformer模型的整体架构,包括编码器(Encoder)和解码器(Decoder)的结构。 |
| 内容角色(content_role) | 说明本章在全文中的作用。 | 本节作为模型架构章节的核心部分,具体定义了Transformer的组件构成、数据流向及关键数学公式,为后续子模块(如注意力机制)的详细描述奠定基础。 |
| 本章关注点(focus) | 指导本章的信息提取。 | 关注Transformer整体架构及其核心组件的专业定义。重点识别‘Transformer’作为基于自注意力和前馈网络的序列转导模型;‘Encoder’和‘Decoder’作为堆叠的自注意力和点式全连接层结构;‘Positional Encoding’作为注入序列顺序信息的正弦/余弦函数机制;‘Embeddings’及‘Softmax’作为输入输出向量化及概率预测的标准组件。 |
| 依据位置(overview.shard_ids) | 定位本章概述依据。 | SH009、SH010、SH011、SH027、SH028、SH029 |
| 待确认/补充说明(ontology_specific.uncertainties) | 保留范围判断与待核对说明。 | 候选提示中的'model'、'input sequence'、'output sequence'等词过于泛化,缺乏独立的专业定义语境,故未纳入核心术语。'Table 1'中的'complexity per layer'等属于性能指标而非架构组件定义。 |
Why Self-Attention
| 字段 | 用途 | 真实输出(节选) |
|---|---|---|
| 章节概述(overview) | 说明本章讲什么。 | 本节旨在通过对比自注意力层与循环层、卷积层,阐述采用自注意力机制的动机。 |
| 内容角色(content_role) | 说明本章在全文中的作用。 | 该章节作为‘Why Self Attention’部分,从计算复杂度和并行化能力两个维度论证自注意力相对于传统RNN和CNN架构的优势,并提及自注意力带来的模型可解释性益处。 |
| 本章关注点(focus) | 指导本章的信息提取。 | 关注用于对比分析的核心网络层类型及其性能指标。重点识别‘self attention layer’(自注意力层)、‘recurrent layer’(循环层)和‘convolutional layer’(卷积层)作为比较对象;识别‘computational complexity’(计算复杂度)和‘parallelized computation’(并行化计算)作为评估标准;识别‘separable convolution’(分离卷积)作为降低复杂度的特定卷积变体;识别‘attention head’(注意力头)和‘interpretable models’(可解释模型)作为自注意力的特性描述。 |
| 依据位置(overview.shard_ids) | 定位本章概述依据。 | SH030 |
| 待确认/补充说明(ontology_specific.uncertainties) | 保留范围判断与待核对说明。 | 候选提示中的'model'、'task'等词过于泛化,缺乏具体专业定义语境,故未抽取。'point wise feed forward layer'虽被提及为组合的一部分,但本节核心在于层间对比,故主要聚焦于前文提到的三类层及分离卷积。 |
细读与整理后:同一批词变成什么样?
以 feed 为例,读到介绍前馈网络的段落时,模型留下了这条批注:
作为标题及正文中'Feed Forward Networks'(前馈网络)的一部分,指代该特定网络结构类型。
整理时,模型结合上下文和相关候选词,将它归入完整术语 position-wise feed forward network,并保留 feed forward network、FFN 等别名。
本轮整理后的交付表包含 160 条候选,下面展示与前面三个候选词对应的真实结果:
| 字段 | Attention mechanism | Transformer | position-wise feed forward network |
|---|---|---|---|
| 保留编号(id) | J0016 | J0055 | J0630 |
| 规范名称(name) | Attention mechanism | Transformer | position-wise feed forward network |
| 别名(aliases) | attention | 空 | feed forward network、FFN、position-wise feed-forward network |
| 定义(definition) | 指Transformer架构中用于建模序列依赖关系的核心计算模块,完全替代了传统的循环和卷积结构。其基本形式是一种注意力函数,将查询(Query)和一组键值对(Key-Value pairs)映射到输出,其中查询、键、值和输出均为向量,输出是值的加权求和。在本文中,具体实现包括缩放点积注意力(Scaled Dot Product Attention)和多头注意力(Multi Head Attention)。 | 指一种全新的简单网络架构,完全基于注意力机制,摒弃了传统的循环和卷积结构。它用于序列转导任务,允许更显著的并行化计算,并通过堆叠自注意力和点式全连接层构建编码器和解码器。它是第一个完全基于注意力的序列转导模型。 | 指Transformer编码器和解码器每一层中包含的全连接前馈网络,应用于每个位置且彼此独立相同。由两个线性变换组成,中间夹有一个ReLU激活函数。其数学表达见表后公式。输入和输出维度为 ,内部层维度为 。 |
| 定义依据位置(claims.shard_ids) | SH003、SH014、SH020、SH022 | SH003、SH008、SH011 | SH026 |
| 原文证据(claims.text,节选) | We propose a new simple network architecture, the Transformer, based solely on attention mechanisms, dispensing with recurrence and convolutions entirely. | We propose a new simple network architecture, the Transformer, based solely on attention mechanisms, dispensing with recurrence and convolutions entirely. | In addition to attention sub layers, each of the layers in our encoder and decoder contains a fully connected feed forward network, which is applied to each position separately and identically. |
| 原候选映射(original_member_ids) | J0005、J0016 | J0125、J0055 | J0039、J0630、J0770、J0078、J0332 |
| 上一轮对象(prior_ids) | J0005、J0016 | J0125、J0055 | J0039、J0630、J0770、J0078、J0332 |
| 处理方式(route) | repaired | repaired | repaired |
| 发现的问题(noise_types) | duplicate | duplicate | duplicate、name_truncation |
| 整理理由(reason,节选) | J0005 ('attention mechanism') 和 J0016 ('attention') 均指代Transformer的核心机制。 | J0125 ('first sequence transduction model') 和 J0055 ('transformer') 均指Transformer模型。 | 该组包含5个候选对象(J0039, J0630, J0770, J0078, J0332),均指代Transformer架构中的位置全连接前馈网络。 |
| 修改记录(changes) | 合并J0005和J0016,统一名称为'Attention mechanism'、整合了SH003, SH014, SH020, SH022中的定义和应用描述 | 合并J0125和J0055,统一名称为'Transformer'、整合了SH003, SH008, SH011中的架构定义、first sequence transduction model是描述性指代而非正式别名,移出别名字段。 | 将名称从'feed-forward network'修正为更准确的'position-wise feed forward network'以匹配SH026标题和描述、合并了J0039, J0770, J0078, J0332的同义概念,将所有变体名称放入别名、更新了定义以包含SH026中具体的数学公式和维度信息、移除fully connected feed forward这一截断别名,保留完整名称及明确缩写。 |
| 字段变化(field_changes,名称) | attention mechanism → Attention mechanism | first sequence transduction model → Transformer | feed forward network → position-wise feed forward network |
| 待确认事项(uncertainties) | 空 | 空 | 空 |
| 复核意见(review_note,节选) | 草稿合并逻辑正确。 | 草稿合并逻辑正确。 | 草稿合并逻辑正确。 |
| 评审状态(review_status) | model_reviewed_pending_user_review | model_reviewed_pending_user_review | model_reviewed_pending_user_review |
| 正式采纳(final_adoption) | not_performed | not_performed | not_performed |
表中前馈网络定义的数学表达为:
规范名称、别名和定义描述关注点;原文证据与位置便于核对;映射、修改及复核记录保留整理过程。这里的 repaired 表示修复后保留,评审状态为待用户评审,正式采纳尚未执行。长文本按表头标注节选,其他值来自实际记录。
小结
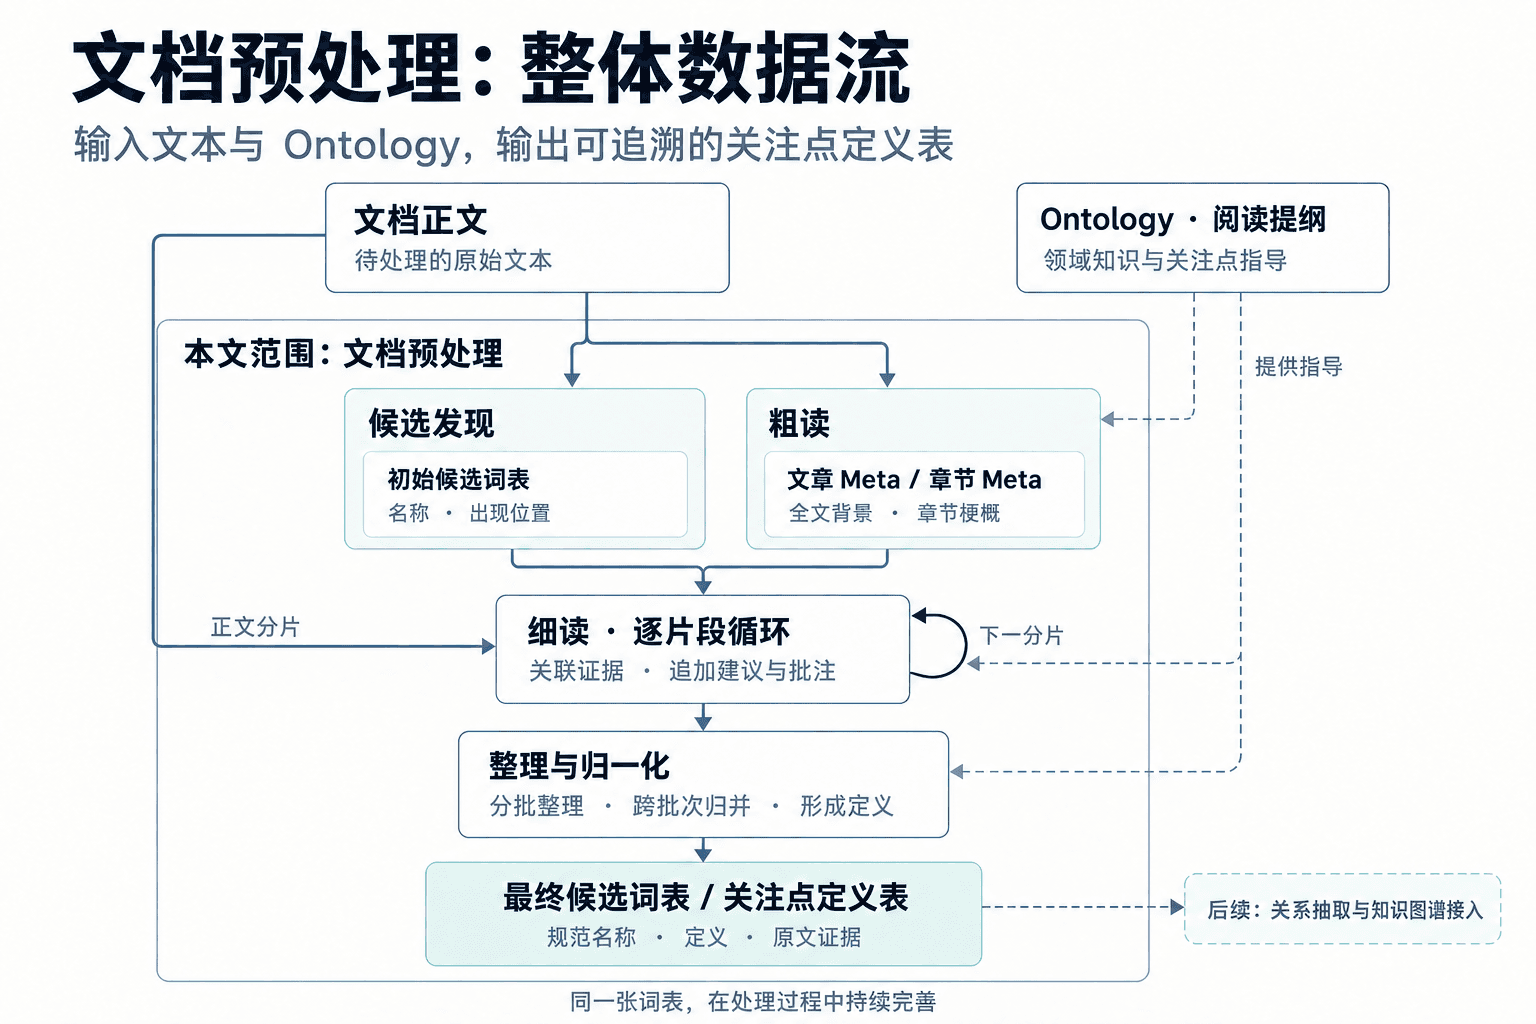
输入文本与 ontology,经过候选发现、粗读、细读与整理,输出包含关键词、定义及相关证据的词表,这就构成了一个可执行、可核对、可迭代的文档预处理模块。贯穿其中的始终是同一张词表,它随着阅读逐步完善,最终成为供后续接入使用的结果。
后续可以利用这些结果开展关系抽取等工作,再将文档作为一个模块接入用户已有的 Ontology 知识图谱。本文讨论的预处理过程,正是在为这一步准备材料。
This work is licensed under Creative Commons Attribution-NonCommercial 4.0 International

